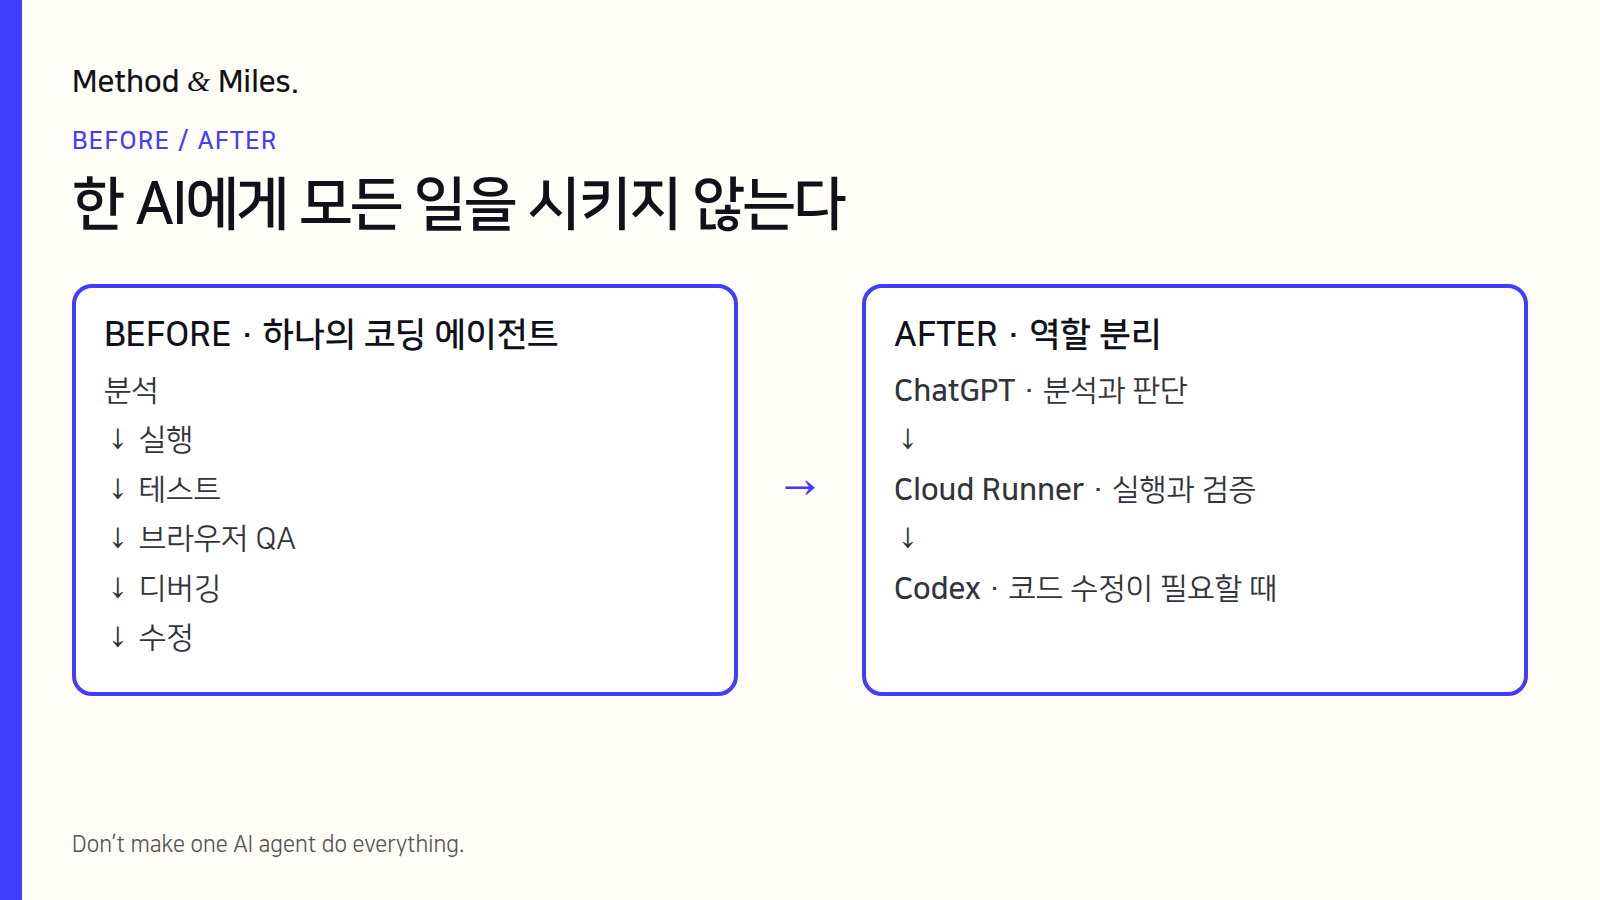
왜 AI 코딩 에이전트에게 테스트 실행과 브라우저 확인까지 모두 맡겨야 할까? Method & Miles는 ChatGPT를 판단 계층으로, GitHub-hosted runner를 실행·검증 계층으로 분리하는 작은 Cloud Runner를 실제 운영 저장소에서 검증했다. 결론은 ‘Codex가 필요 없다’가 아니다. 반복 실행과 검증을 별도 계층으로 옮기면 Codex를 코드 작성·복잡한 디버깅·리팩터링처럼 실제 코드 변경이 필요한 순간에 더 집중시킬 수 있었다.
1. 문제: 강한 코딩 에이전트를 테스트 실행기로 쓰고 있지 않은가
AI 코딩 에이전트는 기능 구현, 복잡한 리팩터링, 마이그레이션처럼 실제 엔지니어링 작업에 강하다. OpenAI도 Codex를 이런 end-to-end coding work를 수행하는 전문 에이전트로 설명한다. 그런데 작은 저장소 검증, 반복 Node 테스트, 브라우저 smoke QA, 스크린샷 확보까지 같은 전문 에이전트에 계속 맡기면 ‘코드를 바꾸는 능력’과 ‘증거를 수집하는 실행 환경’이 한 덩어리로 묶인다.
이번 실험의 질문은 단순했다. 판단은 ChatGPT가 하고, 반복 실행은 이미 사용하는 GitHub의 hosted runner가 하도록 분리하면 어떨까? 이 구조가 작동한다면 Codex는 모든 단계의 기본 실행기가 아니라 실제 구현이 필요한 때 호출하는 specialist가 된다.
2. 처음 검토한 해법: MCP와 별도 서버
처음에는 ChatGPT가 원격 서버의 도구를 직접 호출하는 MCP + VPS 구조를 검토했다. 장점은 명확하다. 서버에 필요한 도구를 설치하고 ChatGPT가 그 기능을 호출할 수 있으면 원격 개발 환경을 만들 수 있다.
하지만 2026년 9월 기준 OpenAI의 full MCP write/modify 지원은 Business·Enterprise·Edu에 beta로 순차 확대 중이고, Pro의 custom MCP는 read/fetch 중심 제약이 남아 있다. 별도 VPS를 쓰면 서버 유지, 네트워크 노출, 권한, 비용, 패치 관리도 추가된다. 우리의 목표는 ‘최대한 강한 원격 서버’가 아니라 ‘반복 검증을 안전하고 싸게 분리하는 것’이었다.
3. 질문을 바꿨다: 서버를 주는 대신 역할을 나눈다
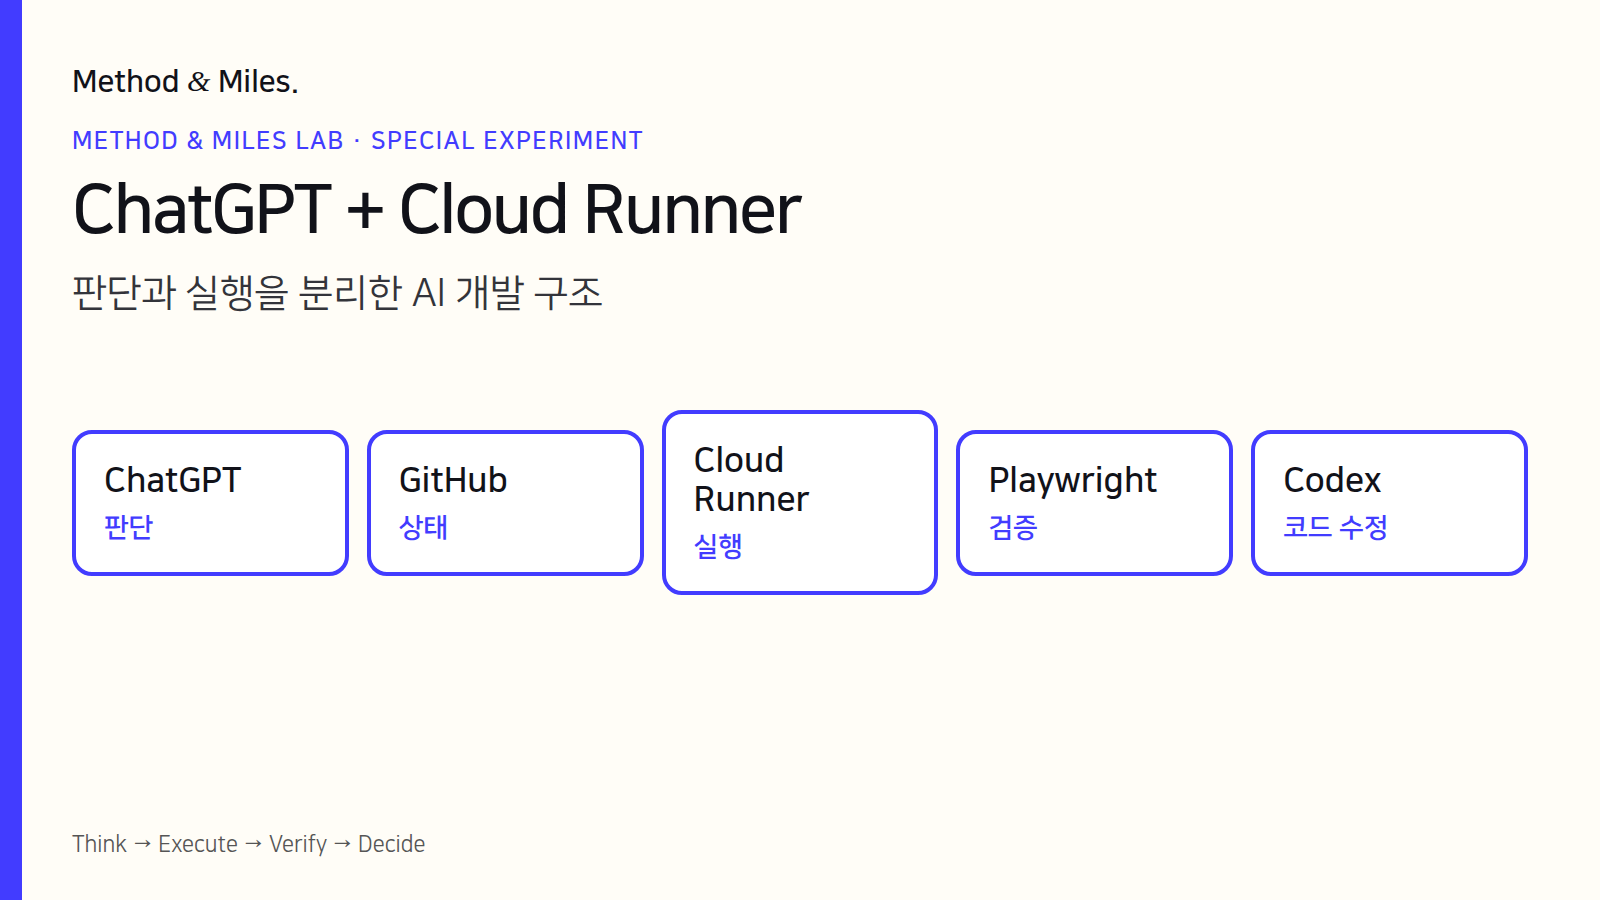
구조는 다섯 역할로 나눴다. ChatGPT는 문제를 분석하고 다음 행동을 결정한다. GitHub는 요청과 상태, 증거의 중심이 된다. GitHub-hosted runner는 정해진 작업만 실행한다. Playwright는 실제 브라우저를 열어 화면을 확인한다. Codex는 코드가 실제로 바뀌어야 할 때만 호출한다.
중요한 포인트는 runner가 자율 코딩 에이전트가 아니라는 점이다. 외부 텍스트를 shell command로 바꾸지 않고, 미리 허용한 몇 가지 고정 작업만 실행한다. ‘무엇을 할지’는 ChatGPT가 결정하지만, ‘아무 명령이나 실행할 권한’을 주지는 않았다.
Method & Miles의 실제 private repository에서 두 단계 PoC를 진행했다. 공개 글에서는 내부 파일명, branch, workflow 이름, 실행 ID, Secret 이름은 노출하지 않는다. 대신 검증 범위만 설명한다.
Repository validation: 기존 전체 검증 명령을 cloud runner에서 실행
Fixed Node test: 미리 지정한 Node 테스트를 고정 명령으로 실행
Browser smoke: runner 내부에서 로컬 빌드를 띄우고 Playwright Chromium으로 실제 페이지 확인
Responsive evidence: 모바일 390×844와 데스크톱 1280×720 화면 스크린샷 생성
Structured evidence: PASS/FAIL/ERROR, 테스트 결과, 실패 목록, artifact 정보를 구조화된 결과로 저장
Round trip: ChatGPT가 작업을 넘기고, runner가 실행한 뒤, ChatGPT가 결과와 artifact를 다시 읽어 다음 판단을 수행
6. 실험 결과: Phase 1과 Phase 2에서 확인된 것
[실험 결과] 수동 실행 단계에서는 repository validation, 고정 Node test, Playwright Chromium browser smoke가 모두 PASS했다. 브라우저 검증에서는 모바일·데스크톱 viewport 스크린샷도 생성됐다.
[실험 결과] 자동 handoff 단계에서는 ChatGPT가 구조화된 요청을 GitHub에 기록하고, GitHub Actions가 자동으로 runner를 시작한 뒤, 고정 Node test 결과와 artifact를 생성하고, ChatGPT가 그 결과를 다시 읽는 end-to-end loop가 PASS했다.
[실험 결과] 처음 검토한 Issue 기반 trigger는 기존 운영 자동화의 다른 trigger와 경계가 겹치는 문제가 발견돼 폐기했다. 이후 production과 분리된 전용 handoff 경로로 바꿨다. 성공 결과만 남기기보다 이 실패가 오히려 ‘자동화는 trigger isolation까지 검증해야 한다’는 중요한 기준을 만들었다.
7. 가치: 코딩 에이전트를 덜 쓰는 것이 아니라 더 필요한 곳에 쓴다
Local PC 의존 감소: 테스트가 GitHub-hosted VM에서 돌아간다.
별도 VPS 불필요: 현재 검증 범위에서는 서버를 상시 운영하지 않는다.
추가 실행 서비스 불필요: 새로운 유료 execution service를 도입하지 않았다.
반복 QA 분리: test, build validation, browser smoke 같은 반복 작업을 specialist 밖으로 옮길 수 있다.
안전 경계가 단순하다: arbitrary command를 받지 않고 fixed allowlist만 허용한다.
[가설] 이 구조가 장기적으로 Codex 사용량을 얼마나 줄이는지는 아직 측정하지 않았다. 따라서 절감률은 제시하지 않는다. 다만 ‘실제 코드 수정이 없는 검증 작업’을 별도 실행 계층으로 보낼 수 있다는 사실은 이번 PoC에서 확인했다.
8. 비용: ‘무료’보다 ‘추가 증분비용 0원 가능성’이 정확하다
GitHub 공식 문서에 따르면 private repository의 표준 GitHub-hosted runner는 계정 플랜에 포함된 Actions minutes를 먼저 사용하고, 포함량을 넘으면 추가 사용이 과금될 수 있다. 현재 GitHub Free는 월 2,000분, Pro는 3,000분의 표준 runner 시간이 포함된다. 따라서 ‘GitHub Actions는 무제한 무료’라고 말하면 틀리다.
[실험 결과] 이번 PoC는 새 VPS, 별도 DB, paid test platform, paid agent framework를 추가하지 않는 구조로 구현했다. [제약] runner 실행 빈도가 늘면 포함 minutes와 artifact storage를 계속 관리해야 한다. 계정 청구서 기준의 월 절감액은 아직 측정하지 않았다.
9. Cloud Runner vs Codex: 무엇을 어디에 맡길까
작업
Cloud Runner
Codex
기존 repository check
적합
가능하지만 과할 수 있음
고정 test 반복
적합
필수 아님
브라우저 smoke QA
적합
진단 후 수정 필요 시
스크린샷·artifact 증거
적합
필수 아님
새 기능 구현
부적합
적합
복잡한 multi-file 수정
부적합
적합
리팩터링·디버깅
문제 재현/검증
실제 수정
OpenAI는 Codex를 기능 구현, 복잡한 리팩터링, 마이그레이션 등 실제 엔지니어링 작업을 수행하는 coding agent로 포지셔닝한다. 이번 구조의 목적은 그 능력을 부정하는 것이 아니라, 단순 반복 실행을 별도 계층으로 분리하는 것이다.
10. 누구에게 유용하고, 어디서부터는 맞지 않는가
이 방식은 ChatGPT를 이미 쓰고 있고 GitHub repository에서 작은 제품이나 자동화를 만드는 Vibe Coding 사용자, Indie Hacker, 1인 개발자, 비개발 Founder, 소규모 팀에게 특히 이해하기 쉽다. ‘코드는 AI가 도와주는데 테스트와 검증이 매번 사람 PC에 묶이는’ 상황에서 가치가 크다.
반대로 runner가 코드까지 자율 수정해야 하거나, 복잡한 interactive debugging이 필요하거나, repository마다 완전히 다른 shell command를 자유롭게 실행해야 한다면 이 PoC 범위를 그대로 확장해서는 안 된다. 그런 작업은 Codex 같은 전문 coding agent 또는 별도로 설계한 개발 환경이 더 적합하다.
11. 최종 판단: 하나의 강한 Agent보다 역할 분리가 더 관리하기 쉬웠다
이번 실험에서 가장 중요한 결과는 ‘Codex를 없앨 수 있다’가 아니었다. 판단·실행·검증·코드 수정을 분리하면 비용, 사용량, 안전 경계와 검증 가능성을 각자 관리할 수 있었다.
ChatGPT decides. Cloud Runner executes and verifies. Codex changes code when code must change.
이 접근은 완성된 범용 제품도, 모든 repository에 그대로 꽂는 turnkey solution도 아니다. 그러나 작은 allowlist와 증거 중심 검증만으로도 AI 개발 workflow의 역할을 재배치할 수 있다는 것은 실제 PoC로 확인했다.
편집 메모: 이 글은 2026년 9월 12일 Method & Miles private 운영환경에서 완료한 AI Cloud Runner PoC와 같은 날 재확인한 OpenAI·GitHub·Playwright 공식 문서를 기준으로 작성했습니다. 내부 repository 식별자, branch·workflow·request 파일명, 실행 ID, Git SHA, Secret 및 Production controller 명칭은 보안과 운영 분리를 위해 공개하지 않았습니다. Codex 사용량 절감률과 금액 절감률은 측정하지 않았으며, GitHub Actions 포함 사용량과 제품 정책은 이후 변경될 수 있습니다.